https://arxiv.org/abs/2608.27454
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
Agent skills package specialized knowledge and workflows into reusable resources that extend AI agent capabilities. Recent work automatically discovers such skills from agent experience, which enables agents to progressively adapt through interaction. Howe
arxiv.org
에이전트 스킬은 특화된 지식과 작업 절차를 재사용 가능한 자원으로 묶어, AI 에이전트의 능력을 확장한다. 최근 연구들은 에이전트가 수행한 경험으로부터 이러한 스킬을 자동으로 발견하는 방법을 제안해 왔고, 이를 통해 에이전트가 상호작용을 거치며 점진적으로 적응할 수 있게 되었다. 그러나 스킬 개발을 이끄는 통찰은 대개 최적화 과정의 이력 속에 흩어진 채 남아 있어, 여러 반복 과정에서 체계적으로 재사용되기 어렵다는 문제의식에서부터 출발한거 같다. 축적에 대한? 관리에 대한? 고민을 나도 누구나 하고 있다는 생각이며 매우 공감한다. (스킬을 만드는데 빠져있다가도 수정하고 안쓰기도하고 다시 또 찾고 써보고 이게아닌가봐 맞나봐등을 반복 필요하겠지하고 만들어진 스킬 재사용히트율이 좋았었나도 생각해보게됨)
여튼 본 논문은 WikiSkill을 제안한다.
WikiSkill은 LLM Wiki의 지식 축적 철학을 에이전트 스킬 업데이트 문제에 적용한 사례이다.
원시 경험을 그대로 스킬에 반영하지 않고, 먼저 wiki layer에 축적·정제한 뒤, 검증을 거쳐 실행 가능한 skill layer로 반영한다는 점이 핵심이다.
따라서 이 논문은 “팀 공용 지식 관리” 자체보다는 “공용 지식을 기반으로 에이전트 스킬을 지속적으로 개선하는 방법”에 가깝다.
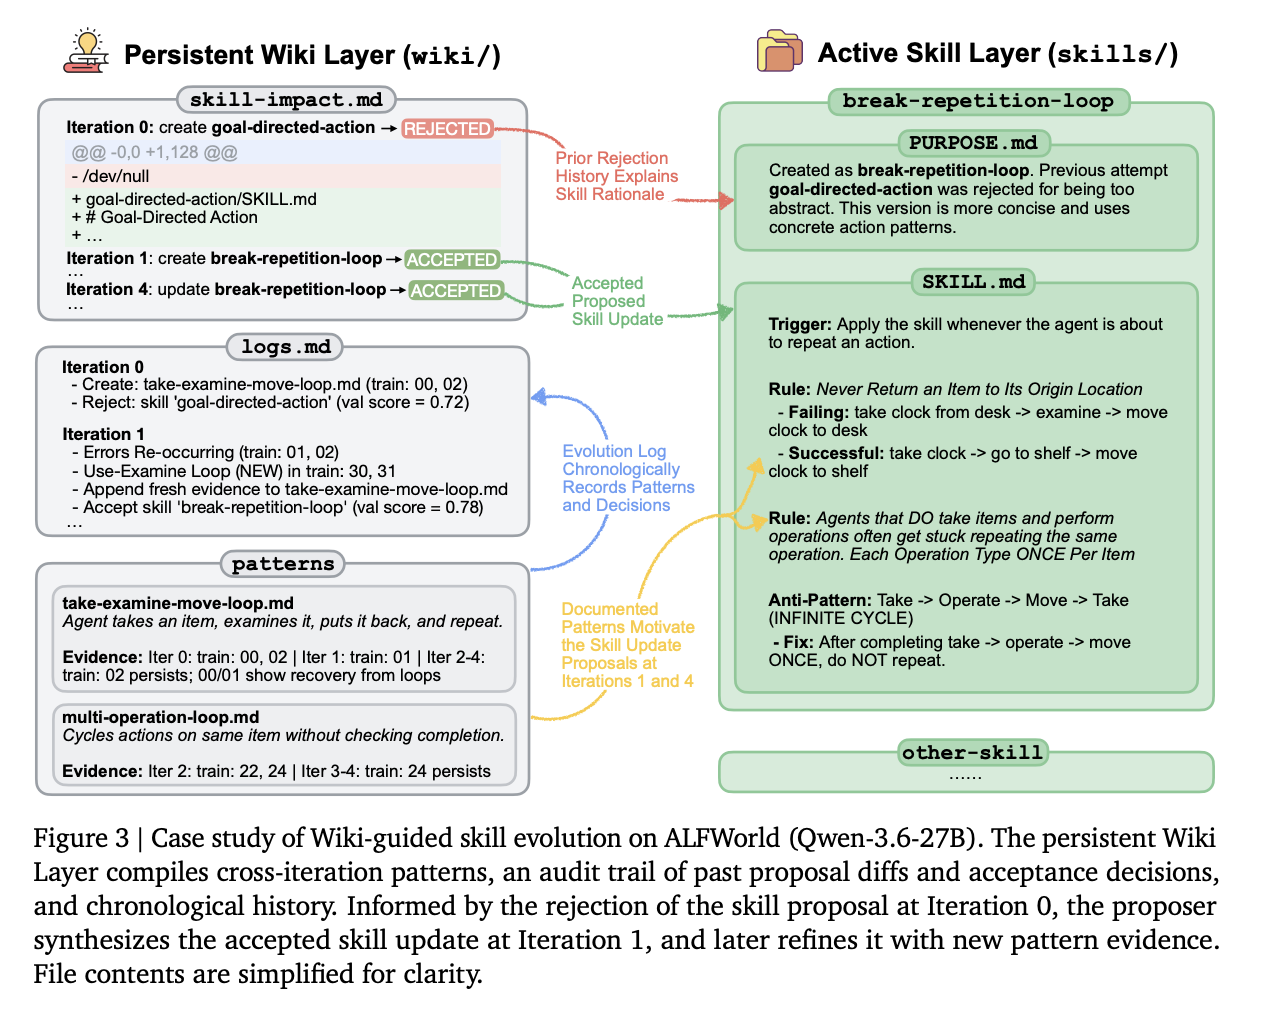
즉, WikiSkill은 에이전트 스킬과 지속적인 지식베이스, 즉 위키를 함께 진화시키는 프레임워크이다. 큰 관점에서 WikiSkill은 원시 실행 경험, 축적된 지식, 실행 가능한 스킬을 분리한다. 그리고 에이전트의 경험을 지속적으로 위키에 통합하여, 이후의 스킬 업데이트가 이 지식을 기반으로 이루어지도록 한다. 원시 실행 경험, 축적된 지식은 llmwiki를 이해하고 있다면 공감할것이라고 생각한다.
해당 논문의 특징은 또 하나 더 있는데 스킬 진화가 모델 스케일링을 보완한다는 점을 발견했다. 일반적으로 더 큰 모델일수록 진화된 스킬로부터 더 큰 이득을 얻었다. 반대로 작은 모델도 스킬을 활용하면, 스킬을 사용하지 않는 훨씬 큰 모델보다 더 나은 성능을 보일 수 있었다.
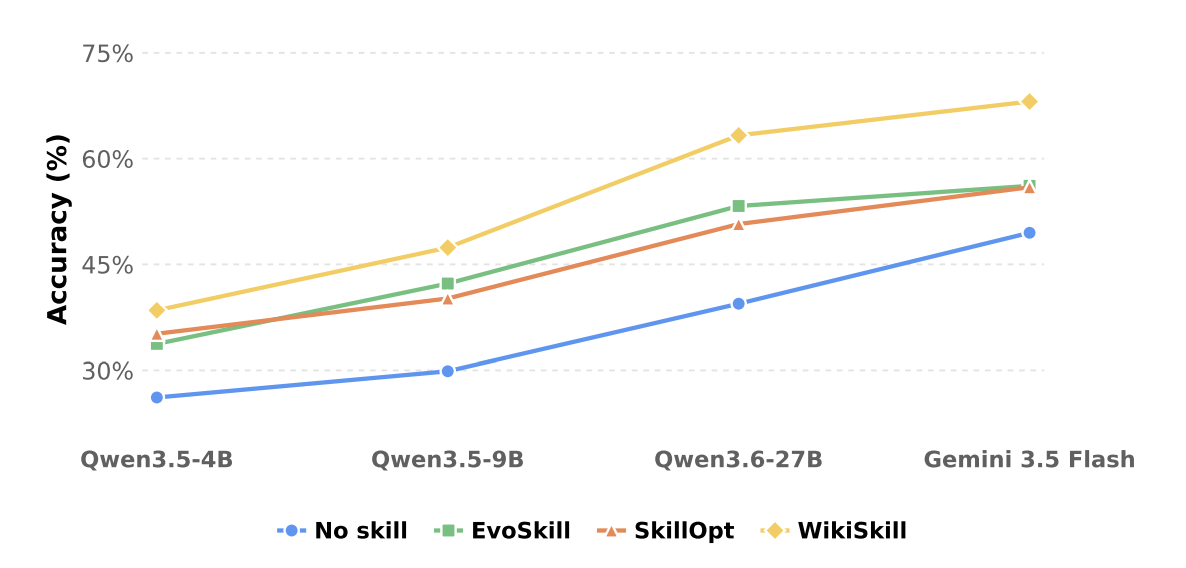
또 하나의 발견은 진화된 스킬이 모델 간, 그리고 모델 패밀리 간에도 효과적으로 전이된다는 점이다. 심지어 어떤 경우에는 다른 모델이 진화시킨 스킬이 자기 자신이 진화시킨 스킬보다 더 좋은 성능을 내기도 했다. 마지막으로, 절제 실험을 통해 위키에 지속적으로 지식을 축적하는 것이 효과적인 스킬 진화에 핵심적이라는 점을 확인했다는 내용이다.
이 논문에서 말하는 "진화"는 모델을 파인튜닝해서 파라미터를 바꾸는 진화가 아니라, 에이전트가 작업하면서 남긴 실행 경험을 모아 위키 지식으로 정리하고, 그 위키를 근거로 스킬 파일을 계속 개선하는 절차적 진화를 의미한다.
큰 방법론은 에이전트가 문제를 풀고 → 그 실행 로그를 저장하고 → 성공/실패 원인을 위키에 정리하고 → 그 위키를 보고 스킬을 고치고 → 검증 성능이 좋아지면 반영하고, 나쁘면 스킬만 롤백한다.
그런데 위키는 롤백하지 않고 계속 누적한다.
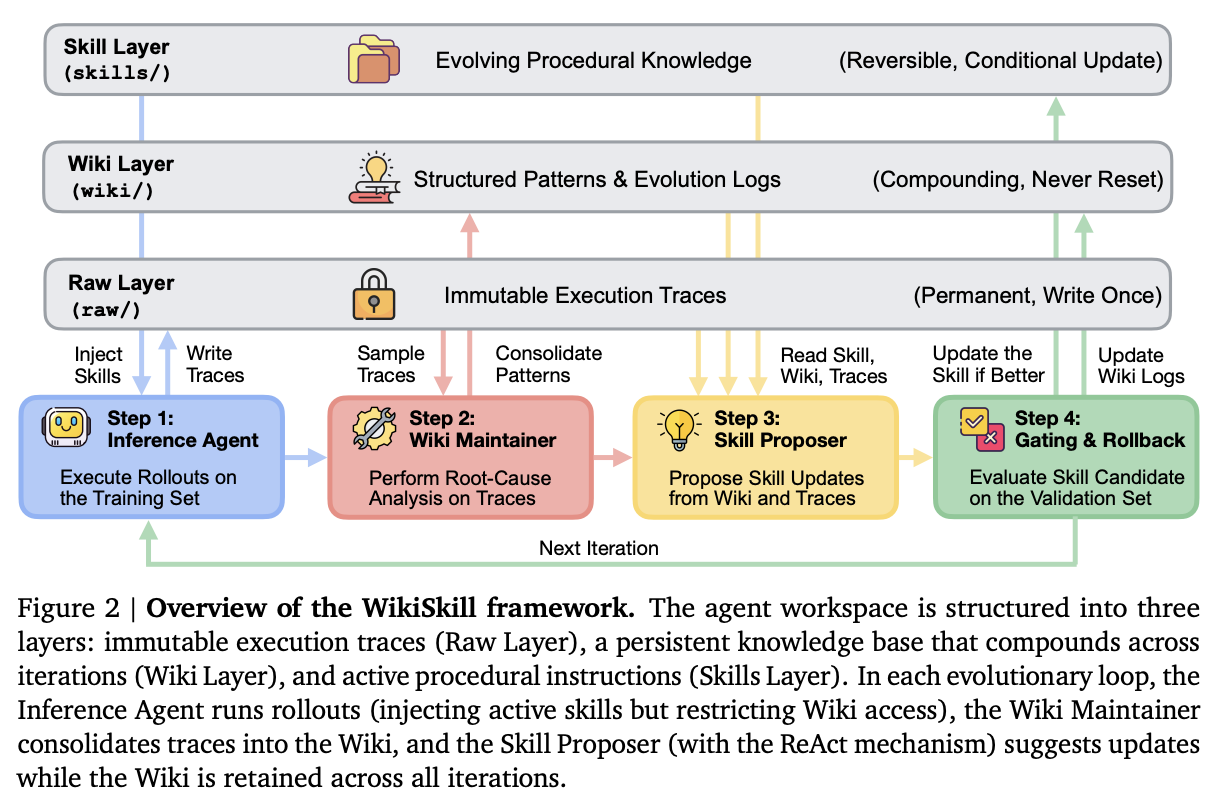
큰 흐름은 단순하다.
에이전트가 문제를 풀고 → 실행 로그를 남기고 → 성공/실패 원인을 위키에 정리하고 → 그 위키를 보고 스킬을 고치고 → 검증 성능이 좋아지면 반영하고, 나쁘면 스킬만 롤백한다.
그런데 여기서 재미있는 점은 위키는 롤백하지 않고 계속 누적한다는 것이다. 스킬 업데이트가 실패하더라도, 그 실패 자체가 다음 업데이트를 위한 경험이 되기 때문이다. “이렇게 고쳐봤더니 오히려 성능이 떨어졌다”는 것도 이후에는 중요한 지식이 된다.
이 부분을 보면서 강화학습과 비슷하다는 생각이 들었다. 에이전트가 어떤 작업을 수행하고, 그 결과를 성공/실패로 평가하고, 그 평가를 바탕으로 다음 행동 방식을 고친다는 흐름이 있기 때문이다.
다만 일반적인 강화학습처럼 모델 파라미터를 직접 업데이트하는 방식은 아니다. 강화학습이 모델 안의 정책을 바꾸는 것이라면, WikiSkill은 모델 바깥의 wiki와 skill 파일을 바꾼다. 즉, 모델 자체를 학습시키는 것이 아니라, 모델이 참고하고 실행하는 외부 지식과 절차를 계속 개선하는 방식에 가깝다.
이렇게 보면 raw/, wiki/, skills/의 역할도 조금 더 선명해진다.
| raw/ | 에이전트가 실제로 수행한 실행 trace, tool call, 성공/실패 로그를 원본으로 저장 |
| wiki/ | raw 로그에서 반복되는 패턴, 실패 원인, 개선 포인트, 진화 기록을 정리 |
| skills/ | 다음 실행 때 에이전트가 실제로 참고할 절차적 지식과 instruction |
| validation score | 새 skill update가 좋아졌는지 확인하는 기준 |
| rollback | 성능이 나빠진 skill update는 반영하지 않는 장치 |
처음에는 이 논문을 팀 공용 지식이나 LLM Wiki를 잘 만드는 관점에서 보기 시작했다. 그런데 읽어보니 이 논문은 “좋은 위키를 어떻게 만들까” 자체보다는, 에이전트가 쌓은 경험을 위키에 남기고, 그 위키를 다시 스킬 업데이트에 쓰는 방법에 더 가깝다.
그래서 내가 이해한 핵심은 이렇다.
WikiSkill은 LLM Wiki의 지식 축적 방식을 에이전트 스킬 업데이트에 적용한 구조다.
실행 경험을 바로 스킬에 덧붙이지 않고, 먼저 위키에 정리한 뒤, 그 정리된 지식을 바탕으로 스킬을 고친다.
그리고 스킬은 검증 결과에 따라 반영하거나 되돌리지만, 위키는 계속 남겨서 다음 시도에 사용한다.
결국 이 논문은 팀 공용 지식 관리 전체를 설명하는 논문이라기보다는, 공용 지식이 에이전트의 행동 개선으로 이어지려면 어떤 루프가 필요한지를 보여주는 사례로 보면 될 것 같다.
Appendix
논문리뷰시 참고하면 좋은 링크
- https://www.connectedpapers.com/main/617144689bd33a62f2fbde99abc27c13eaf5e84d/WikiSkill%3A-Compiling-Agent-Experience-into-Persistent-Knowledge-for-Skill-Evolution/graph
- Connected Papers는 일반적인 마인드맵이라기보다 논문 관계 지도
- 가까운 논문: 인용·참고문헌 구조가 유사한 연구
- 큰 원: 인용 횟수가 많은 논문
- 색상: 발표 연도
- Prior Works: 이 연구의 기반이 된 선행 연구
- Derivative Works: 이 분야를 후속으로 발전시킨 연구
'ML&AI' 카테고리의 다른 글
| 통계적 가설검정: t검정·z검정·카이제곱 검정 (0) | 2026.09.23 |
|---|---|
| Jev vs BERT/NLI (0) | 2026.09.22 |
| GPT-5.6 Luna 프롬프트 캐싱 실험 (0) | 2026.09.18 |
| EDA와 시각화: 숫자 너머의 분포를 읽고 오독을 막는 법 (0) | 2026.09.18 |
| 데이터 품질: 모델보다 먼저 믿을 수 있는 베이스 데이터를 만드는 일 (1) | 2026.09.18 |
